【AWS認定】Claudeのスキルを学習コーチにしてAWS Certified Generative AI Developer – Professionalに合格した学習方法
目次
- はじめに
- AWS Certified Generative AI Developer – Professionalとは
- 学習の全体像:Claudeのスキルを「学習コーチ」にする
- 【学習方法】5つのステップ
- 【技術解説】学習で整理したAmazon Bedrockの使い分け
- 【注意点】生成AIで資格の勉強をするときに気をつけたこと
- 受験してみて
- まとめ
1. はじめに
こんにちは!ベンジャミンの松延(まつのぶ)です!
2026年10月4日に、AWS Certified Generative AI Developer – Professional(以下、AIP)に合格しました。
以前、AWS Certified AI Practitioner(AIF)の勉強方法を記事にしましたが、今回はそのProfessional版です。AIFが「生成AIの基礎知識」を問う試験だったのに対し、AIPは「生成AIを本番環境のアプリケーションにどう組み込むか」という設計判断を問う試験で、求められる深さが大きく違うと感じました。
そして今回の学習には、少し変わった方法を取り入れました。AnthropicのClaudeに「スキル」として学習コーチの役割を持たせ、計画 → 解説 → 演習 → 苦手分析 → 克服確認というサイクルを回したことです。
この記事では、その学習方法と、学習を通じて理解できた「Amazon Bedrockまわりの設計判断」をシェアしていきたいと思います。前半(第3章・第4章)では学習方法を、後半(第5章)では、学習の中で整理したAmazon Bedrockのサービスの使い分けを紹介します。
AWS認定の試験内容には守秘義務があるため、本記事では実際の出題内容には触れず、公開されている試験ガイドと公式ドキュメントで確認できる範囲のみを扱います。また、紹介する学習方法は私個人の経験に基づくものであり、合格を保証するものではありません。前提知識や確保できる学習時間によって合う方法は変わるので、参考の一つとしてご覧ください。試験の概要は2026年11月時点の情報です。最新の情報は公式の試験ガイドをご確認ください。
対象読者とこの記事でわかること
本記事は、次のような方を対象としています。
- AIPの受験を検討している、または学習中の方
- 生成AIを使って資格の勉強を効率化したいと考えている方
- Amazon Bedrockを使った生成AIアプリケーションの設計で、サービスの使い分けに迷うことがある方
そして、この記事を読み終えると、次のことがわかります。
- AIPの試験概要と、5つのドメインの配点
- Claudeのスキルを学習コーチにして、学習サイクルを回す具体的な方法
- AIPの学習で整理した、Amazon Bedrockまわりのサービスの使い分け5つ
2. AWS Certified Generative AI Developer – Professionalとは
AIPは、生成AIの開発者ロールを担う人を対象としたProfessionalレベルの認定です。試験ガイドでは「基盤モデル(FM)をアプリケーションや業務ワークフローに効果的に統合する能力」を検証する試験と説明されています。
試験の概要は次のとおりです。試験時間・問題数・受験料・言語・受験方法は認定ページ、採点対象の内訳・合格ライン・問題形式・ドメインの配点は試験ガイドの記載に基づいています。
| 項目 | 内容 |
|---|---|
| 試験コード | AIP-C01 |
| 試験時間 | 180分 |
| 問題数 | 75問(うち採点対象65問、採点対象外10問) |
| 問題形式 | 択一選択(1つの正解と3つの不正解)、複数選択(5つ以上の選択肢から2つ以上の正解をすべて選ぶ)、順序付け(3〜5個の回答を選び、正しい順に並べる)、マッチング(3〜7個の項目に回答を対応づける) |
| 合格ライン | 750点(100〜1,000点のスケールスコア) |
| 受験料 | 300USD |
| 言語 | 英語、日本語、韓国語、簡体字中国語 |
| 受験方法 | ピアソンVUEのテストセンター、またはオンライン監督付き試験 |
推奨される経験は「AWSまたはオープンソース技術で本番レベルのアプリケーションを構築した経験2年以上」「AI/MLまたはデータエンジニアリングの一般的な経験」「生成AIソリューションを実装した実務経験1年」とされています。
出題範囲は5つのドメインに分かれていて、配点は次のとおりです。
| ドメイン | 内容 | 配点 |
|---|---|---|
| 1 | 基盤モデルの統合、データ管理、コンプライアンス | 31% |
| 2 | 実装と統合 | 26% |
| 3 | AIの安全性、セキュリティ、ガバナンス | 20% |
| 4 | 生成AIアプリケーションの運用効率と最適化 | 12% |
| 5 | テスト、検証、トラブルシューティング | 11% |
ドメイン1と2で6割近くを占めます。RAG(検索拡張生成)、ベクトルストア、エージェント、プロンプト管理といった「作る」側の話が中心で、そこにセキュリティ・コスト・運用・評価が絡んでくる構成です。なお、モデルの開発やトレーニングそのものは対象外と明記されています。
ドメインごとに合格点を取る必要はなく、試験全体で750点を超えれば合格です。
公式ドキュメント:AWS Certified Generative AI Developer – Professional、AWS Certified Generative AI Developer – Professional (AIP-C01) 試験ガイド
公式ドキュメント:AWS Certified Generative AI Developer – Professional (AIP-C01) 試験ガイド(PDF版)
3. 学習の全体像:Claudeのスキルを「学習コーチ」にする
Claudeのスキル(Agent Skills)とは
Claudeのスキル(Agent Skills)は、Claudeに特定の分野の手順や知識を持たせるための仕組みです。SKILL.mdという指示書と、必要に応じて参照資料やスクリプトをひとつのフォルダにまとめておくと、Claudeが関連する依頼を受けたときに自動で読み込んで使います。
スキルは、次のように段階的に読み込まれます。
- 普段は、スキルの名前と説明(
SKILL.mdの冒頭に書くメタデータ)だけを把握している - 依頼がその説明に合致したときに、はじめて
SKILL.mdの本文を読み込む - 本文から参照されている資料は、必要になったときだけ読む
このため、ドメイン別の詳しい教材をたくさん同梱しても、公式ドキュメントの説明どおり、読まれるまではコンテキストを消費しない仕組みになっています。毎回のチャットで「あなたはAWS認定の学習コーチです。解説はこういう順序で…」と説明し直す必要もなくなります。
公式ドキュメント:Agent Skills – Claude Docs、Use skills in Claude – Claude Help Center、Extend Claude with skills – Claude Code Docs
作った学習コーチスキルの中身
今回使ったのは、AIP向けの学習コーチとして振る舞うスキル(aws-aip-study)です。スキルはClaudeと対話しながら作成し、Claudeのデスクトップアプリで使いました。
前提として、スキルはプログラムを書いて作るものではなく、Markdownの指示書と参照資料をひとつのフォルダにまとめたものです。
Claudeのデスクトップアプリやclaude.aiで使う場合は、フォルダをZIPファイルにして、スキルの設定画面(Customize > Skills)からアップロードして登録します(コード実行とファイル作成の機能を有効にしておく必要があります)。Claude Codeで使う場合は、ホームディレクトリの~/.claude/skills/か、プロジェクトの.claude/skills/の配下にフォルダを置きます。
フォルダ構成は次のようになっています。
aws-aip-study/
├── SKILL.md                  # 学習サイクルの進め方、解説・採点の作法
└── references/
    ├── answer-patterns.md    # 全ドメイン共通の判断ルールと消去法
    ├── common-mistakes.md    # 間違えやすい論点
    ├── aip-c01-domain1.md    # ドメイン1の要点と使い分け
    ├── aip-c01-domain2.md    # ドメイン2
    ├── aip-c01-domain3.md    # ドメイン3
    ├── aip-c01-domain4.md    # ドメイン4
    ├── aip-c01-domain5.md    # ドメイン5
└── diagram-style.md # 図解(SVG)の様式SKILL.mdには、次のようなルールを書いています。
- 目的は設計判断ができるようになること。合格はその結果としてついてくる
- 解説は「仕組み → 生まれた背景 → メリットとデメリット」の順で書き、判断のルールは最後にまとめる。ルールの暗記から始めない
- 専門用語は避けない。ただし最初から使わず、先に日常の言葉で中身を説明してから正式名称を伝える
- 問題は必ず新規に作る。公式問題の文面は再現しない
- 数値・対応可否・新機能は、必ず公式ドキュメントで裏を取り、解説の末尾にURLを付ける
- 採点したら必ず学習ログに記録する
参考までに、SKILL.mdの冒頭と、解説の書き方を指示している部分を抜粋します。冒頭のメタデータ(nameとdescription)は、Claudeがどんな依頼のときにこのスキルを使うかを判断するための説明です。
---
name: "aws-aip-study"
description: "AWS認定試験の学習コーチ。特にAIP-C01の教材を同梱する。試験日から学習計画を立て、
  ドメインの内容を専門用語を噛み砕いて解説し、理解を確認してから練習問題を出して採点、
  その結果から苦手分野を分析して潰し、模擬試験でまた分析する、というサイクルを回す。"
---

### 解説の作法:中学生に説明するつもりで書く

専門用語は避けない。本番の問題文は専門用語で書かれているので、用語を知らないと解けない。
ただし、用語から説明を始めない。先に日常の言葉で「何をするものか」を理解させ、
そのあとで「これを○○と呼びます」と正式名称を伝える。

守ること:
- 身近なものにたとえて説明を始める。ただし、たとえ話で終わらせず、実際の仕組みの説明まで書く
- カタカナ語・略語は初出時に必ず噛み砕く
- 「なぜそれが要るのか」から話す。機能の羅列は記憶に残らない
- 似ているサービスや機能と並べて説明する。AWSの試験は使い分けを問う
- 試験でどう問われるかを添える
学習サイクルの全体像は次のとおりです。
① 計画を立てる(最初に1回)
        ↓
② ドメイン学習:解説 → 理解確認 → 練習問題 → 採点
        ↓
③ 苦手を分析:採点結果を学習ログに記録し、弱点を特定
        ↓
④ 苦手を潰す:弱点に絞って再解説 → 再演習 → 潰れたか確認
        ↓
  (②〜④を範囲ごとに繰り返す)
        ↓
⑤ 模擬試験:複数ドメイン横断で本番形式
        ↓
  (模擬試験の結果をもとに、③〜④を繰り返す)
1回の解説や採点で終わらせず、苦手が特定され、潰れたことを確認するところまで回すことを重視しています。そのために、会話をまたいでも誤答の履歴が残るよう、学習ログをファイルに書き出すようにしています。
4. 【学習方法】5つのステップ
ここからは、実際にどう学習を進めたかを、ステップごとに紹介します。
受験前の私の状況は、学習期間が約2か月、保有資格は10個で、AI PractitionerとMachine Learning Engineer – Associateで生成AIと機械学習の基礎は一通り学んでいた状態でした(保有資格の一覧は記事の末尾に載せています)。
ステップ1:試験日から逆算して計画を立てる
最初に、試験日・確保できる学習時間をClaudeに伝えて、学習計画を作ってもらいました。
計画を作るときの考え方は次のとおりです。
- 配点順が基本。ドメイン1(31%)とドメイン5(11%)の1問は価値が違う
- すでに強い領域は薄く、弱い領域は厚くする
- 確保できる学習時間は、自分で見込んだ時間の半分で見積もる。
- 忙しいと、「毎日1時間」の計画どおりに時間を取れない日も出てきます。
- そこで最初から「平日は15分で3問、週末に1時間」のように少しずつ長く続ける形で組み、ゼロの日を作らないことをいちばんの目標にしました。
- 直前期(残り3〜4日)は新しいことを学ばず、模擬試験と弱点の穴埋めに充てる
- 最後の1〜2日は総復習と体調管理。詰め込まない
計画はファイルに保存し、学習が進んで苦手が見えてきたら組み直します。
ステップ2:解説 → 理解確認 → 演習の順で学ぶ
ドメインごとの学習は、いきなり問題を解くのではなく、まず解説を読んで、理解を確認してから演習するという順序にしました。知らないことを問われても、当てずっぽうを覚えるだけになりやすいからです。
範囲はドメイン単位ではなく、タスク単位や3〜4個の概念単位で区切ります。一度に詰め込んでも残らないためです。
解説は「中学生に説明するつもりで」と指示しています。たとえばベクトルストアなら、いきなり「埋め込みを永続化してANNで近傍探索を…」と始めるのではなく、こう説明してもらいます。
文章の「意味」を数字の並びに変換して、意味が近いものは数字も近くなるようにします。そうすると「意味が似た文章を探す」が「近い数字を探す」という単純な計算になる。この数字の並びを 埋め込み(embedding)、それを大量にしまって高速に探せるようにした保管庫を ベクトルストア と呼びます。中身に納得してから正式名称を覚える、という順番です。
理解の確認は「わかりましたか?」ではなく、「自分の言葉で言い換えてみてください」「では、この場合はどれを使いますか?」と判断を求める形にしています。「はい」と答えるのは簡単ですが、判断を求められると理解の穴がすぐに見えるからです。
練習問題は1問ずつ出してもらい、1問ごとに採点と解説を受けます。解説の構成は、SKILL.mdで次のように指示しています(読みやすさのため一部を省略しています)。
### 採点と解説

解説が薄いと、学習者は「正解が何か」しか持ち帰れない。それでは次の問題が解けない。
解説は次の構成で書く。まず全体像(なぜこれが正解か)を掴ませ、次に消去法(なぜ他が不正解になるか)を鍛え、
最後に一般化(次に活かす)する流れになっている。

1. 判定と、要件の分解
   問題文のどの語が要件を決めたのかを明示する。「この問題は『運用オーバーヘッド最小』と
   『既存の全バケット』の2語で決まっている」のように、問題文のどこを見ればよかったかを具体的に示す。

2. 正解の根拠(なぜ正解になるか)
   - まず、そのサービス/機能が実際に何をするのかを仕組みのレベルで説明する
   - なぜそれで要件が満たされるのかを、要件の各項目に1つずつ紐づける
   - メリットとデメリット(トレードオフ)に触れる
   - 最後に、判断のルールを短くまとめる。ルールの説明から始めない

3. 各不正解の選択肢がなぜ不正解になるか(ここが本体)
   選択肢を1つずつ、それぞれ2〜4文で扱う。1行で切り捨てない。
   - そのサービス/構成が本来は何をするものか(不正解の選択肢も実在の技術なので、ここで知識が増える)
   - どの要件に照らして不正解になるのか(「技術的には動くが、〜という要件に対して〜だから」)
   - どういう問題文だったらこれが正解になるか

4. 間違えやすいポイントの整理
   知識ギャップ / 修飾語の読み落とし / 方式の読み落とし / 手順の省略 のどれかを明示し、
   次に同じ間違いをしないための一般ルールを渡す。

5. 関連する使い分けの確認
   その問題の周辺にある紛らわしい使い分けを1〜2組示す。

6. 参考ドキュメント(必須)
特に3が効きました。不正解の選択肢も実在の技術なので、「この条件ならこっちが正解になる」まで知ると、似た論点の問題にも対応しやすくなります。
ステップ3:間違えた理由を分類して記録する
採点したら、結果を学習ログに記録します。このとき、ドメインだけでなく、「なぜ間違えたか」を4つに分類します。
| 間違えた理由 | 中身 | 対策 |
|---|---|---|
| 知識ギャップ | 仕様を知らない | 仕組みから理解して覚える |
| 修飾語の読み落とし | 「運用の手間を最小に」などの条件を見落とし、技術的に良い案を選ぶ | 修飾語だけを見て判断する短い練習 |
| 方式の読み落とし | サービス名は合っているが、方式や順序が要件と矛盾している | 同じサービスで方式だけ違う選択肢を読み分ける |
| 手順の省略 | 知っているのに、選ぶ個数の確認や最後の選択肢まで読むことを省いて落とす | 確認の手順を毎回同じように行う |
同じ「間違えた」でも、知らないのか、読み落としたのか、手順を省いたのかで対策が大きく変わります。ドメイン別に集計するより、この分類で集計したほうが次の一手がはっきりしました。
このうち「修飾語の読み落とし」については、修飾語の強さを区別する読み方が効きました。「〜しなければならない」「規制上」のような強い条件は、満たさない選択肢を先に除外する足切りの条件として扱い、「できるだけ速く」のような希望は、残った選択肢の中での優先順位として扱います。この順序を逆にすると、希望を優先した結果、満たすべき条件を落とした選択肢を選んでしまうおそれがあります。
学習ログは、次のような表をMarkdownのファイルに追記していく形です(内容は例です)。
## 2026-07-15 Domain1 Task1.4 練習問題

| 問 | 論点 | 結果 | 間違えた理由 | メモ |
|---|---|---|---|---|
| 1 | ベクトルストア選定(強一貫性) | ✅ | — | |
| 2 | ANN vs 正確k-NN | ❌ | 修飾語の読み落とし | 「厳密さが要る」を見落とし |
| 3 | メタデータフィルタ | ✅ | — | 理由は曖昧だった |

**この回の所見:** 「厳密さ」「必ず」といった語への反応が弱い。
ステップ4:苦手を潰し、潰れたことを確認する
学習ログから「本当の苦手」を1〜3個に絞り、そこだけを集中的に潰します。ドメイン全体の復習には戻りません。
ステップ3の表にある「対策」は、SKILL.mdでは分類ごとに次のように書き分けています(一部を省略しています)。
## 苦手克服(潰して、潰れたことを確認する)

間違えた理由ごとに対策が違う。理由の見極めを誤ると、対策をしても苦手が残る。

### 知識ギャップの対策
覚えるしかないが、丸暗記させない。なぜそういう仕様なのか、背景まで説明すると定着する。
1. その事実を仕組みから説明する
2. 似ているサービスや機能と並べて説明する(Aが使えないなら、代わりに何が使えるのか)
3. その場で1〜2問出して、使える状態か確認する

### 修飾語の読み落としの対策
知識はあるので、読み方の訓練をする。
- 修飾語だけの短い練習: 問題文全体を読ませない。修飾語だけを見せて、その語があるときに何を優先するかを答えさせる。
  例: 「運用オーバーヘッド最小」なら、マネージドなサービスを優先する。「コード変更なしで」なら、設定だけで切り替えられる選択肢を優先する。これを10個ほど続ける
- 通常の演習に戻ったら、解く前に修飾語を指摘させる。「この問題の判断を決めている語はどれですか?」
- 要件を全部数えてから語を絞る

### 方式の読み落としの対策
選択肢の動詞・方式まで読む訓練をする。
- 同じサービス名で方式だけ違う選択肢を並べて、どちらが要件に合うか判断させる
- 処理順序の誤りは、正しい順序と誤った順序を並べた図が一番効く

### 手順の省略の対策
知識ではなく、確認の手順を毎回同じように行えるようにする。短いセットで直っても克服判定を出さず、
時間内フル模試の終盤で崩れないことを確認して初めて克服とする。
特に大事だと感じたのは、潰れたことの確認です。
- 同じ論点を、角度を変えて2〜3問出してもらう
- 正解したら、なぜそれを選んだかを説明する
- 少し時間を置いて、別の日にもう一度出してもらう(対になる論点は逆方向でも)
説明を読んで「わかった」と思っても、時間を置くと崩れることがあります。時間差で再出題してもらい、正解できたら学習ログに「克服確認」と記録して、ようやく潰れたと判断しました。
ステップ5:模擬試験で本番の形に慣れる
範囲を一通り回したら、複数ドメインを横断する模擬試験を作ってもらいます。スキルでは、フルの75問は負担が大きいので普段は20〜25問のミニ模試を勧めつつ、本番前にフル模試を最低1回は通すことをルールにしています。私は本番前に、180分・75問のフル模試を2回通しました。
フル模試を勧める理由は、「手順の省略」が疲労の中でないと確かめにくいからです。短い演習ではできている確認作業も、問題数が増えて疲れてくると省きがちになります。そのためスキルでは、解答のときに次の順序を守るよう求めます。
- 要件の数を数える
- 判断を決める語(修飾語)を書き出す
- 最後に選択肢の記号を選ぶ
複数選択の問題は、選択肢を読む前に「選ぶ個数」を書き出します。頭の中だけで照合すると、疲れてきたときに抜けやすいからです。語を書き出すために問題文を読み直すことで、読み落としに気づくきっかけを作るのがねらいです。
なお、試験ガイドには、順序付けとマッチングの形式も挙げられています。模擬試験を作ってもらうときに、これらの形式も混ぜてもらうと、本番で形式に戸惑いにくくなります。
使った教材
スキルでの学習とあわせて、AWS Skill Builderの公式練習問題と教材も併用しました。使ったのは次の学習プランです。
Exam Prep Plan: AWS Certified Generative AI Developer – Professional (AIP-C01 – English)
5. 【技術解説】学習で整理したAmazon Bedrockの使い分け
AIPは「同じサービスでも、要件しだいで正解が変わる」という問われ方が多い試験だと感じました。実際の設計でも、運用の手間を減らすか、細かく制御するかといったトレードオフがあり、要件によって選ぶものが変わります。
ここで紹介するのは、ステップ2の「不正解の選択肢が、なぜ要件を満たさないのか」の解説を繰り返す中で整理できた使い分けです。そのうち、Amazon Bedrock(以下、Bedrock)まわりの5つを紹介します。いずれも試験ガイドのドメインに沿ったテーマで、内容は公式ドキュメントで確認しています。
1. クロスリージョン推論とProvisioned Throughput、どちらでスループットを上げるか
どちらも「スループットを上げたい」という要件で登場しますが、仕組みは大きく異なります。
| クロスリージョン推論 | Provisioned Throughput | |
|---|---|---|
| 何をするか | 推論リクエストを複数のリージョンの計算資源に振り分ける | モデルユニット単位で、一定のスループットを固定費で購入する |
| 料金 | 追加のルーティング料金なし(呼び出し元リージョンの料金) | 時間課金。コミットなし/1か月/6か月から選び、長いほど割安 |
| データの処理場所 | 地理的境界内(US・EU・APACなど)、またはグローバル | 購入したリージョン |
| 向いている要件 | スロットリングを減らしたい、(グローバルの場合は)コストも抑えたい | 一定の処理量をあらかじめ確保しておきたい。カスタムモデルを安定した性能で動かしたい |
クロスリージョン推論は、リクエストを処理できる場所を広げる仕組みです。一方で、公式ドキュメントにも「モデルのスループットを上げるにはProvisioned Throughputを購入できる」とあり、容量を確保するのはこちらの役割です。
また、カスタマイズしたモデルは、Provisioned Throughputを購入して専用の容量で動かせます。公式ドキュメントでは、もう一つの選択肢として、カスタムモデルデプロイによるオンデマンド推論も案内されています(この場合はProvisioned Throughputの設定は不要で、使った分だけの課金です)。ただし、カスタムモデルデプロイを使えるのは、対応するベースモデルで、2025年7月16日以降にカスタマイズしたモデルに限られます。リージョンも2026年11月時点では米国東部(バージニア北部)と米国西部(オレゴン)のみで、東京リージョンは対象外です。
さらに、対応するベースモデルはリージョンごとに異なり、Amazon Nova Lite・Nova 2 Lite・Nova Micro・Nova Proは米国東部(バージニア北部)、Meta Llama 3.3 70B Instructは米国西部(オレゴン)です。
なお、推論プロファイル(クロスリージョン推論の仕組み)は、現時点ではProvisioned Throughputをサポートしていません。そのため、Provisioned Throughputで購入した容量を、推論プロファイル経由で使うことはできません。
もう一つ、データの所在地の要件にも注意が必要です。グローバルのクロスリージョン推論は、対応するモデル(公式ドキュメントではClaude Sonnet 4.5が例に挙げられています)で約10%のコスト削減になる一方で、世界中の商用リージョンで処理され得ます。データを特定の地域から出せない要件があるなら、地理的境界内に収まるプロファイルを選びます。
大まかには、「スロットリングを減らしたい」ならクロスリージョン推論、「容量を確保したい」ならProvisioned Throughput、と整理できます。
公式ドキュメント:Route model inference requests across AWS Regions with cross-Region inference、Increase model invocation capacity with Provisioned Throughput in Amazon Bedrock、Set up inference for a custom model、Deploy a custom model for on-demand inference
2. Guardrailsのストリーミング、同期モードと非同期モードのどちらを選ぶか
Amazon Bedrock Guardrails(以下、Guardrails)をストリーミング応答に適用するときは、2つのモードを選べます。
| 同期モード(デフォルト) | 非同期モード | |
|---|---|---|
| 動き | 応答のチャンクをバッファし、Guardrailsの検査が終わってからユーザーに送る | チャンクをすぐにユーザーに送り、裏で検査する。不適切な内容を検知したら、それ以降のチャンクをブロック |
| レイテンシ | 検査のぶん遅延が出る | 遅延なし |
| 精度 | 各チャンクが検査されてから届く | 検査が終わるまで、不適切な内容が届く可能性がある |
| 機密情報のマスキング | 対応 | 非対応 |
非同期モードは、機密情報(PII)のマスキングに対応していません。公式ドキュメントにも、警告として明記されています。
つまり「個人情報をマスクしなければならない」という要件があるなら、体感速度を多少犠牲にしても同期モードを選ぶことになります。ステップ3で触れた、強い条件を先に足切りに使う読み方が、そのまま当てはまる例です。
なお、非同期モードにしてもGuardrailsの料金は下がりません。AWS公式ブログでは、非同期モードはストリーミングの経路からGuardrailsのレイテンシを取り除くものの、評価されるテキストユニットの数は減らないと説明されています。「非同期にすれば安くなる」というわけではない点に注意が必要です。
非同期モードは、InvokeModelWithResponseStreamのリクエストボディのamazon-bedrock-guardrailConfigの中で、streamProcessingModeにASYNCHRONOUSを指定して有効にします。
{
  "amazon-bedrock-guardrailConfig": {
    "streamProcessingMode": "ASYNCHRONOUS"
  }
}
なお、Converse APIのConverseStreamを使う場合は、指定する場所と値が異なり、guardrailConfigのstreamProcessingModeにasyncを指定します。どちらのAPIを使っているかで書き方が変わるので注意が必要です。
Amazon Bedrock AgentCore(以下、AgentCore)でGuardrailsを使うときにも、この話はつながってきます。AgentCoreのHarnessでGuardrailsを使うには、モデル設定のAPI形式をconverse_streamにします(省略時のデフォルトもconverse_stream)。
また、AgentCore GatewayのPolicyで使える効果はpermit・forbid・suppressOutputの3つで、「マスクして通す」効果は用意されていません。PIIのマスクが必要な守りをどこに置くかは、JAWS-UG KYUSHU QUEST 2026 in Fukuokaでの登壇資料で、移行の検証結果とあわせて紹介しているので、よろしければご覧ください。
公式ドキュメント:Configure streaming response behavior to filter content、Models and instructions – Amazon Bedrock AgentCore、Getting started with guardrails in the AgentCore CLI
AWS公式ブログ:Best practices for applying Amazon Bedrock Guardrails to code generation workflows
3. ナレッジベースの検索結果を、メタデータでどう絞り込むか
Amazon Bedrock Knowledge Bases(以下、ナレッジベース)で、部署や文書の種類ごとに検索結果を絞り込みたいときは、メタデータによるフィルタリングを使います。
メタデータは、S3のオブジェクトに付けるユーザー定義メタデータではなく、元の文書と同じフォルダに<ファイル名>.metadata.jsonという別ファイルを置いて持たせます。
{
  "metadataAttributes": {
    "department": {
      "value": { "type": "STRING", "stringValue": "sales" },
      "includeForEmbedding": false
    }
  }
}- ファイル名は、元の文書のファイル名に
.metadata.jsonを付けたもの(例:report.pdf.metadata.json) - 元の文書と同じフォルダに置き、サイズは10KB以下
includeForEmbeddingをtrueにすると、メタデータがチャンクの本文と一緒に埋め込まれ、検索の類似度にも影響する。falseならフィルタ専用
設計判断としては、「この部署の文書だけを返したい」のように結果を確実に絞り込みたい場合は、メタデータフィルタのような決定論的な仕組みを使うのが基本だと考えています。プロンプトで「営業部の文書だけを参照して」と指示しても、それはモデルへのお願いにとどまり、指示どおりになるとは限りません。
公式ドキュメント:Include metadata in a data source to improve knowledge base query、Configure and customize queries for managed knowledge bases
4. 生成AIの評価を、LLM-as-a-judgeと人のどちらで行うか
Bedrockの評価機能には、大きく分けて次の種類があります。
| 評価の種類 | 中身 | 向いている場面 |
|---|---|---|
| プログラムによる評価 | 用意したデータセット(または組み込みデータセット)で、計算可能な指標を出す | タスクの基本性能を素早く測る |
| LLM-as-a-judge | 生成用のモデルとは別の評価用LLMが、応答を採点し、採点理由を説明する | 大量の応答を定期的に評価する |
| 人による評価 | 社員や専門家のチームが、指標に沿って評価・比較する | 主観的・曖昧な判断、専門知識が要る判断、リスクの高いケース |
| RAGの評価 | ナレッジベースなどのRAGが、関連情報を取得し適切な応答を生成できているかを測る(期待する応答などの正解データと照らして評価する) | 検索と生成の品質を分けて確認する |
多くの場合、全部を人が見るのも、全部をLLMに任せるのも、最適とは限りません。大量の応答はLLM-as-a-judgeで評価し、判断が分かれるものやリスクの高いものだけを人が見る組み合わせが使いやすいと思います。
公式ドキュメント:Evaluate the performance of Amazon Bedrock resources、Evaluate model performance using another LLM as a judge
5. エージェントを、Bedrock AgentsとAgentCore Runtimeのどちらで作るか
エージェントの構築にも、マネージドの度合いが違う選択肢があります。
- Bedrock Agents:エージェントの作り方そのもの(指示、アクショングループ、ナレッジベースの連携など)を、設定ベースで提供する
- AgentCore Runtime:Strands Agents、LangGraph、CrewAIなど、任意のフレームワークで書いたエージェントを動かすための実行基盤を提供する。セッションの分離やオブザーバビリティはAgentCore側が担う
前者は作り方まで含めて任せられるぶん手軽で、後者はフレームワークやモデルを自由に選べるぶん、エージェントのロジックは自分で書きます。ここでも「運用の手間を減らしたい」のか「柔軟に制御したい」のかで判断が分かれます。なお、この2つの中間にあたる選択肢として、モデル・ツール・指示文を設定で宣言してエージェントを動かすAgentCore Harnessもあります。Harnessについては1本目の記事で扱っています。
AgentCoreについては、これまでの記事で実際に手を動かして検証しているので、あわせて読んでいただけるとうれしいです。
- 【ハンズオン】Amazon Bedrock AgentCore Managed Harness × Managed Knowledge Basesで作るマネージドRAGエージェント
- 【ハンズオン】Amazon Bedrock AgentCore Runtime instancesをAWS CDKで構築してみよう!
公式ドキュメント:Host agent or tools with Amazon Bedrock AgentCore Runtime
6. 【注意点】生成AIで資格の勉強をするときに気をつけたこと
生成AIを学習に使うと効率よく進められる一方で、使い方しだいでは逆効果にもなり得ます。私が気をつけたことを3つ挙げます。
1. 公式ドキュメントで裏を取る
生成AIの知識は、学習時点のものです。特にBedrockまわりは変化が速く、上限値やサービスの対応可否、新しめの機能については、説明が古いままになっていることがあります。それを知らずに覚えてしまうと、試験で間違った知識のまま答えることになります。
そこで、解説の前に公式ドキュメントで確認し、URLを添えることをルールにしました。もう一つ決めておいてよかったのは、確認できなかった場合は「確認できなかった」と正直に書いてもらうことです。それらしい断定が返ってくるよりも、確認できていないことがわかるほうが、自分で調べ直すきっかけになります。
2. 公式ドキュメントと食い違ったら、公式を正とする
教材やWeb上の解説、そして生成AIの説明が、公式ドキュメントと食い違うことはあり得ます。たとえば第5章で紹介したナレッジベースのメタデータは、名前の印象から「S3のオブジェクトメタデータで付ける」と思い込みやすいところですが、公式ドキュメントでは.metadata.jsonという別ファイルで持たせる形式です。
食い違いに気づいたら、公式ドキュメントで確認して、公式を正とする。このルールを先に決めておくと、迷ったときの判断が速くなると思います。
3. 公式の試験問題を再現しない
AWS認定の受験規約では、試験内容の開示が禁じられています。生成AIに「問題を出して」と頼むと、公式の練習問題や模擬試験に近い文面が返ってくることがあるため、問題は新規に作ることをスキルのルールにしました。
参考にするのは、試験ガイドで公開されている問題形式と、「実務のシナリオに制約条件が付く」という設問の一般的な構成だけです。規約を守るために決めたことですが、同じ問題を覚えるのではなく判断の仕方が身につくので、学習効果の面でも良かったと感じています。
7. 受験してみて
無事に合格し、認定バッジも発行されました!
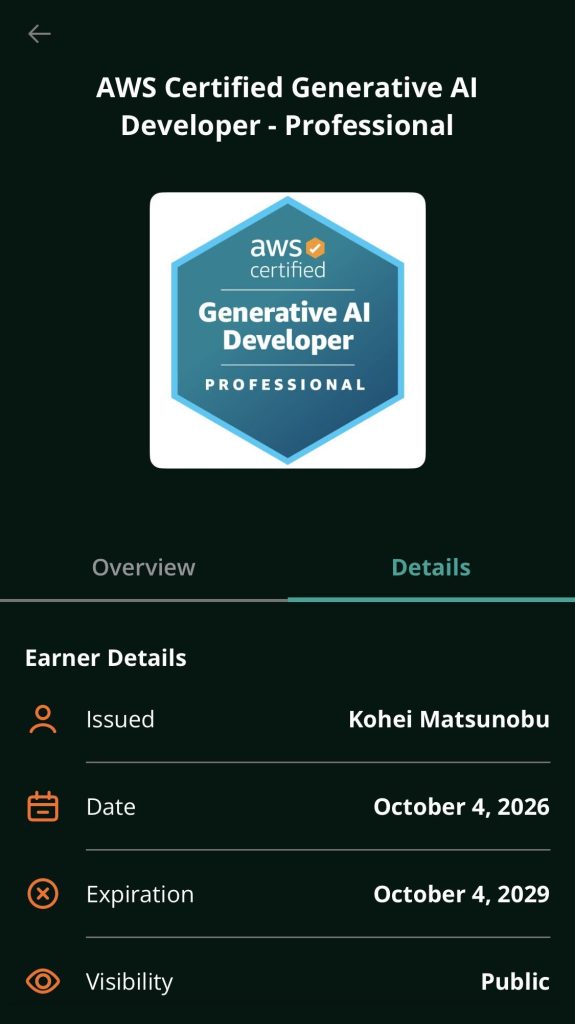
Professionalということもあり、内容はかなり難しく感じました。選択肢を2つまで絞り込めても、そこから正解を選ぶには、サービスの細かい仕様まで理解している必要がある、という手応えです。第5章で、使い分けだけでなく仕様にまで踏み込んで紹介したのはこのためです。
時間配分は、1問あたり2分ほどで解いていく必要があります。180分で75問なので単純計算では1問2分強ですが、迷った問題に戻って見直す時間も考えると、そのくらいのペースが目安になると思います。
コンディションづくりで意識したのは次の2つです。
- 前日はあえて勉強せず、コンディションを整えることに充てる
- 当日はカフェインを摂りすぎない(トイレが近くなります)
180分の長丁場なので、知識と同じくらい、当日の体調と集中力が結果に影響すると感じました。
8. まとめ
今回は、Claudeのスキルを学習コーチにして、AWS Certified Generative AI Developer – Professionalに合格した学習方法をご紹介しました。
- AIPは、生成AIを本番環境に組み込むための設計判断を問う試験で、同じサービスでも要件しだいで正解が変わる
- Claudeのスキルに学習コーチの役割を持たせることで、計画 → 解説 → 演習 → 苦手分析 → 克服確認のサイクルを、会話をまたいで回せた
- 間違えた理由を分類して記録すると、次の一手がはっきりする。特に「潰れたことを時間差で確認する」ことが効いた
- 生成AIで勉強するときは、公式問題を再現しない・公式ドキュメントで裏を取る・食い違ったら公式を正とすることを意識した
試験勉強として始めたことですが、クロスリージョン推論とProvisioned Throughputの使い分けや、Guardrailsのモード選択などは、そのまま実案件の設計でも使える知識になりました。
これからAIPを受験される方の、一助になれば幸いです!
(参考)筆者が受験前に保有していたAWS認定
- AWS Certified Cloud Practitioner
- AWS Certified AI Practitioner
- AWS Certified Solutions Architect – Associate
- AWS Certified Developer – Associate
- AWS Certified SysOps Administrator – Associate(現在の名称はAWS Certified CloudOps Engineer – Associate)
- AWS Certified Data Engineer – Associate
- AWS Certified Machine Learning Engineer – Associate
- AWS Certified Solutions Architect – Professional
- AWS Certified DevOps Engineer – Professional
- AWS Certified Advanced Networking – Specialty